Due diverse esposizioni legali ricadono su qualsiasi team che addestra un modello di intelligenza artificiale, e provengono da due direzioni diverse. La prima è normativa: dal 2 agosto 2026, l'articolo 10 dell'AI Act dell'UE richiede ai fornitori di sistemi di IA ad alto rischio di documentare i propri dataset di addestramento, validazione e test, inclusi i processi di raccolta dei dati e l'origine dei dati. La seconda è civile: un titolare di copyright può affermare che la propria opera è stata utilizzata senza autorizzazione, e l'onere ricade sull'azienda di IA, che deve dimostrare quali dati ha effettivamente utilizzato e come li ha ottenuti.
Entrambe le esposizioni pongono una versione della stessa domanda: cosa contiene il dataset, da dove proviene e quando è stato ottenuto. Questa domanda è ciò che "provenienza" significa nella pratica, ed è utile essere precisi su cosa un registro con marca temporale può e non può dimostrare.
Cosa richiede realmente l'articolo 10
L'articolo 10 si applica ai sistemi di IA ad alto rischio e stabilisce pratiche di governance dei dati che un fornitore deve avere in atto. Gli obblighi riguardano le scelte progettuali fatte nella raccolta dei dati, il processo di raccolta dei dati stesso e l'origine dei dati, le fasi di preparazione come l'annotazione, l'etichettatura e la pulizia, una valutazione se il dataset sia pertinente e sufficientemente rappresentativo per lo scopo previsto, e un esame di possibili distorsioni (bias). Quando un fornitore individua lacune che impediscono la conformità, anche questo va documentato.
Nulla di tutto ciò chiede a un'azienda di dimostrare di aver risolto ogni questione di copyright in un set di addestramento. L'articolo 10 è un regime di qualità e governance dei dati, non un regime di autorizzazione del copyright. Ma rispondervi bene richiede lo stesso registro di base di cui ha bisogno una difesa in materia di copyright: quali dati sono entrati, da dove provengono e quando.
L'esposizione civile separata
Le contestazioni di copyright contro le pratiche di addestramento dell'IA sono un ambito di contenzioso attivo e in corso in molteplici giurisdizioni, con cause intentate da editori, autori, titolari di diritti musicali e archivi fotografici contro i principali sviluppatori di IA. Le teorie giuridiche differiscono per giurisdizione e per caso, e i tribunali stanno ancora affrontando questioni fondamentali come se l'addestramento su materiale protetto da copyright costituisca un uso trasformativo e come gli obblighi di licenza interagiscano con le eccezioni per l'estrazione di dati. Non intendiamo prevedere come si risolverà un caso specifico, e un registro dei dati di addestramento non risolve nemmeno quella domanda.
Ciò su cui si basa realmente una contestazione di questo tipo, in pratica, sono le prove. Se un titolare di diritti afferma che la propria opera è stata raccolta senza autorizzazione, la risposta dell'azienda di IA dipende dalla capacità di dimostrare, con un registro che non ha scritto a posteriori, cosa ha raccolto, da dove e a quali condizioni. Un'azienda che non può ricostruire la propria catena di approvvigionamento dei dati sta argomentando a memoria contro un ricorrente con una contestazione specifica.
Cosa significa "provenienza" per un dataset, in pratica
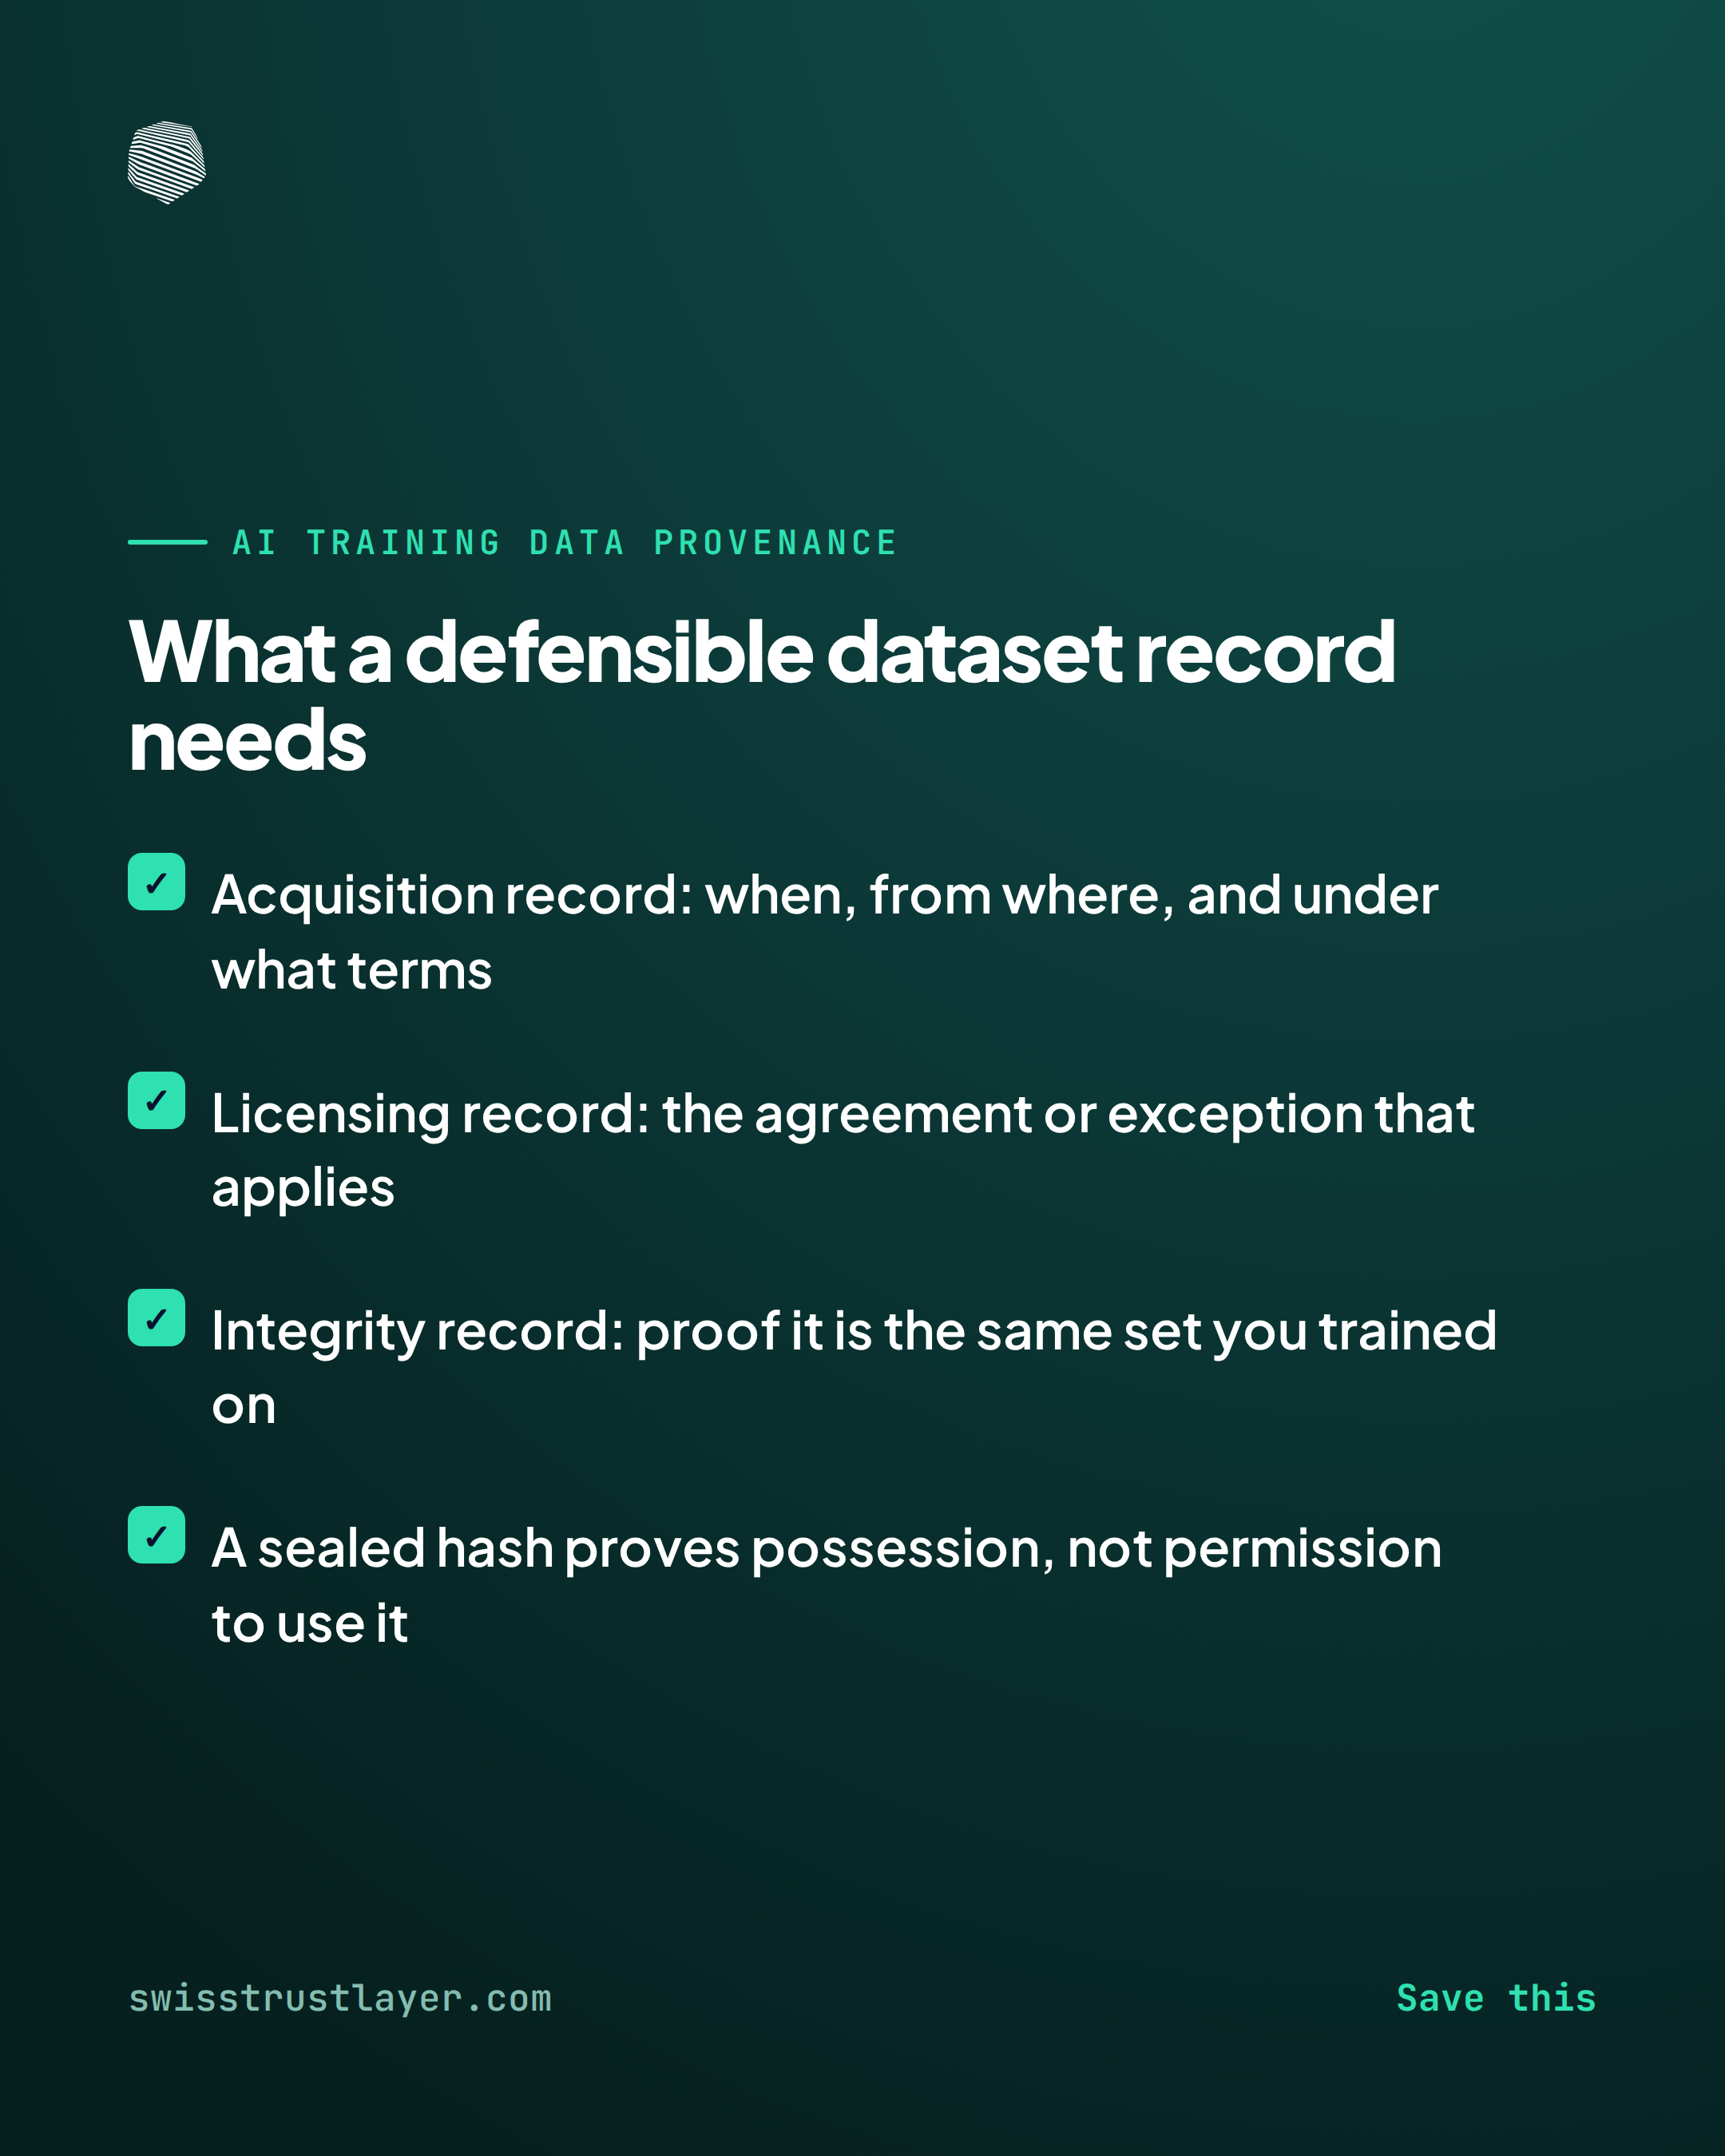
La catena di custodia per un dataset di addestramento si suddivide in tre elementi che vale la pena tracciare separatamente:
- Registro di acquisizione. Quando è stata aggiunta una fonte al corpus, da quale URL, API, licenziante o fornitore, e secondo quale versione dei termini di quella fonte al momento dell'acquisizione.
- Registro delle licenze. Quale accordo, se esiste, copre l'utilizzo, se si tratta di una licenza diretta, di una concessione tramite i termini di servizio di una piattaforma, di una licenza aperta, o dell'applicazione di un'eccezione per l'estrazione di testo e dati come l'articolo 4 della direttiva UE sul copyright nel mercato unico digitale, e se il titolare dei diritti aveva riservato i diritti contro tale eccezione in modo leggibile da una macchina.
- Registro di integrità. La prova che il dataset a cui un'azienda fa riferimento oggi è lo stesso su cui ha effettivamente addestrato il modello, e non una ricostruzione assemblata successivamente ai fini di una controversia.
Di questi tre, il registro di integrità è quello per cui la maggior parte dei team non ha una buona risposta. I registri di acquisizione e di licenza tendono a risiedere in email sparse, contratti con fornitori e wiki interni. Anche laddove esistono, spesso non c'è modo di dimostrare che il dataset citato in quei documenti sia lo stesso insieme di file su cui il modello è stato effettivamente addestrato, mesi o anni dopo.
Cosa dimostra una marca temporale qualificata, e cosa non dimostra
Sigillare un hash crittografico di un dataset al momento dell'acquisizione, con una marca temporale qualificata, crea un registro difendibile in giudizio secondo cui uno specifico insieme di byte esisteva ed era in vostro possesso in un momento specifico. Si tratta di un'affermazione circoscritta ma genuinamente utile. Significa che potete dimostrare a un tribunale, mesi o anni dopo, esattamente come si presentava il dataset quando lo avete raccolto, senza fare affidamento sulla vostra sola parola o su un documento che avrebbe potuto essere modificato successivamente.
È importante essere precisi sui limiti di questa affermazione, perché esagerarla è peggio che non farla affatto. Un hash sigillato dimostra l'esistenza e il possesso in un momento specifico. Non dimostra che avevate l'autorizzazione a utilizzare il contenuto, e non dimostra che il contenuto sia stato ottenuto legalmente in primo luogo. Le licenze e l'autorizzazione sono questioni giuridiche separate a cui una marca temporale non può rispondere da sola. Ciò che fa è eliminare un'intera categoria di controversia, ovvero se siete anche solo in grado di dimostrare cosa avevate e quando, in modo che l'argomentazione effettiva sulle condizioni di licenza possa svolgersi sui fatti anziché su chi dei due racconti degli eventi un tribunale è disposto a credere.
Per un'azienda che affronta un regolatore che chiede informazioni sulla governance dei dati ai sensi dell'articolo 10, o un titolare di diritti che denuncia un uso non autorizzato, la differenza tra "ecco un hash con marca temporale del dataset esatto, sigillato alla data in cui lo abbiamo acquisito, insieme ai nostri registri di licenza" e "riteniamo che questo sia più o meno ciò che abbiamo utilizzato" è la differenza tra una posizione difendibile e una non verificabile.
Dove si inserisce questo in un flusso di lavoro pratico
I team che sviluppano prodotti di IA e devono difendere sia la questione della governance ai sensi dell'articolo 10 sia la sottostante questione del copyright traggono beneficio dal trattare l'acquisizione del dataset come un evento distinto e sigillato, anziché come una cartella continua e modificabile. Calcolate l'hash e sigillate un'istantanea del dataset al momento dell'acquisizione, allegate i termini di licenza applicabili in quel momento, e mantenete questo registro separato da qualsiasi pulizia o filtraggio a valle che avvenga successivamente. Se in seguito sorge una controversia, relativa a una fonte specifica, a una data specifica o a una licenza specifica, il registro esiste già anziché dover essere ricostruito sotto pressione.
La nostra pagina sulla provenienza dei dataset per l'IA spiega come funziona questo processo per i team che hanno bisogno di un registro con marca temporale, ammissibile in tribunale, di cosa conteneva un dataset e quando è stato acquisito, insieme alla documentazione di licenza che risponde alla domanda separata sull'autorizzazione.